


Dans notre précédent article de blog, Anomalous Sound Detection: From Human Ears to AI"nous avons présenté les principaux points douloureux de l'écoute manuelle, introduit la solution de test de son anormal basée sur l'IA de CRYSOUND, décrit de manière générale l'approche d'entraînement et montré comment le système peut être déployé sur une ligne de production TWS. Dans cet article, nous allons plus loin : nous allons approfondir les principes d'analyse de l'algorithme de son anormal basé sur l'IA de CRYSOUND, présenter des configurations de test pratiques et leurs performances en conditions réelles, puis conclure par une liste de contrôle de configuration complète que vous pourrez utiliser pour planifier ou valider votre propre déploiement.
Défis de la détection d'anomalies avec des algorithmes classiques
Dans les usines réelles, les défauts véritables sont à la fois rares et très diversifiés, ce qui rend difficile la constitution d'une bibliothèque exhaustive de signatures sonores anormales pour un entraînement supervisé.
Même des algorithmes basés sur des règles, bien réglés - parfois fortement personnalisés - couvrent rarement toutes les signatures anormales. De nouveaux modes de défaut, des variations subtiles et l'évolution des conditions de production peuvent sortir des seuils prédéfinis ou des gabarits de caractéristiques, entraînant des défauts manqués (escapes).
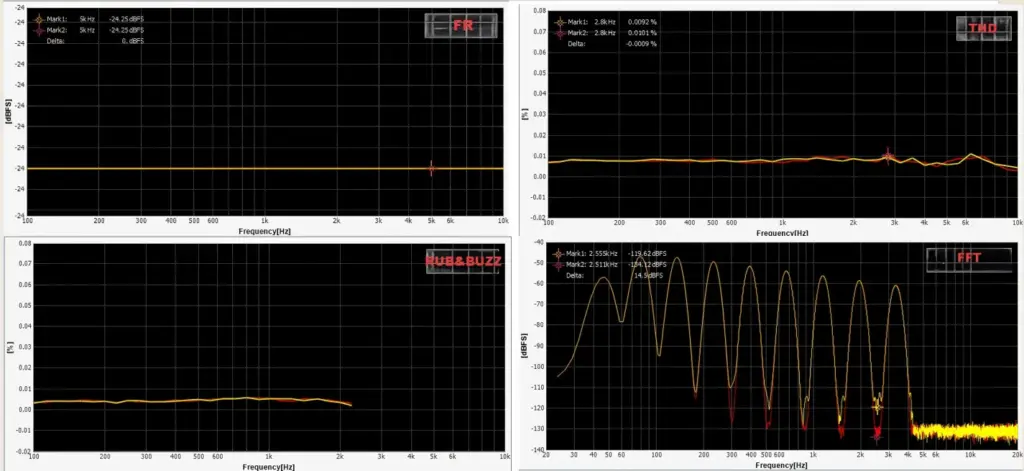
Dans la figure ci-dessous, nous comparons deux fichiers wav que nous avons générés manuellement.
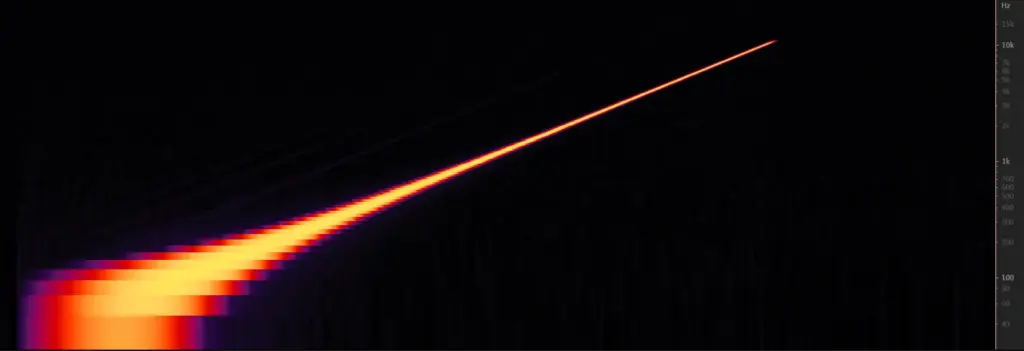
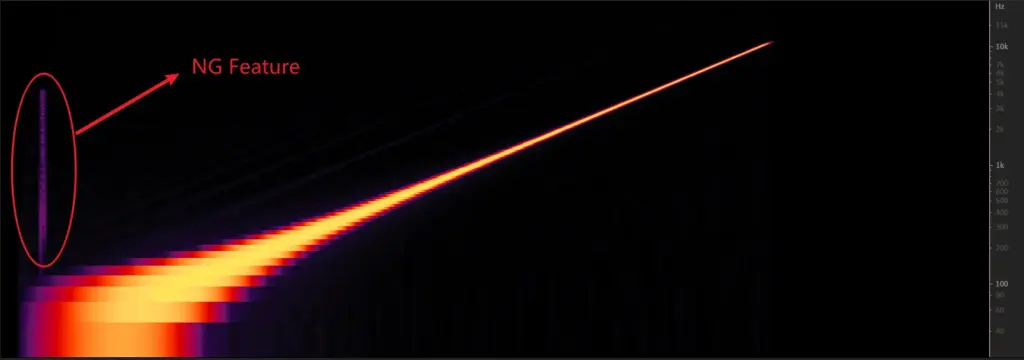
Vous pouvez voir que les contrôles classiques - réponse en fréquence, THD et un algorithme typique de rub & buzz (R&B) - détectent à peine le défaut de bruit injecté de faible niveau ; l'écart global de la courbe n'est que d'environ 0,1 dB. Dans une simple comparaison FFT, les deux fichiers wav présentent bien quelques divergences, mais en conditions de production réelles l'énergie du défaut peut être encore plus faible, ce qui la fait très probablement passer sous les seuils fixes et lui permet de passer au travers. En revanche, dans la représentation temps-fréquence, la signature anormale est clairement visible, car elle apparaît comme un motif structuré dans le temps plutôt que comme un léger changement sur une courbe moyenne unique.
Principe de l'algorithme d'IA de son anormal
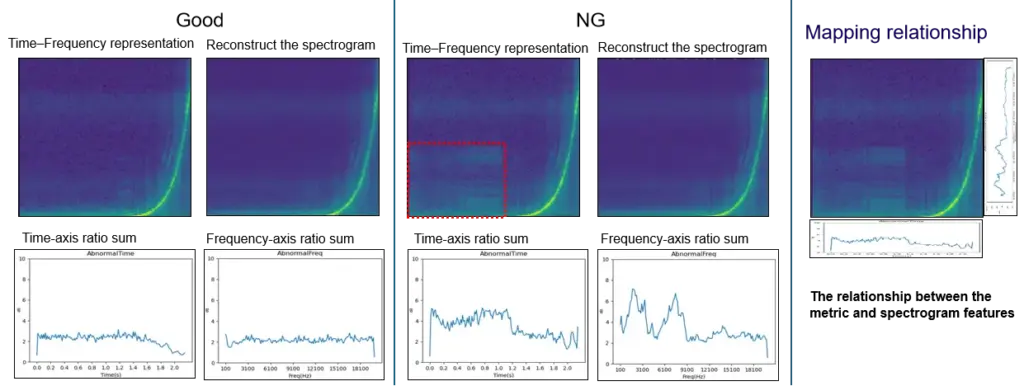
CRYSOUND propose une approche de détection de son anormal basée sur un cadre d'apprentissage profond qui identifie les défauts en reconstruisant le spectrogramme et en mesurant ce qui ne peut pas être bien reconstruit. Cela permet de dépasser les principales limitations des méthodes traditionnelles basées sur des règles et, en termes de principe, d'offrir une couverture de défauts plus large et plus systématique - en particulier pour les signatures anormales subtiles, diverses et encore jamais observées.
La figure ci-dessous illustre le flux de travail central de notre chaîne d'entraînement et d'inférence.
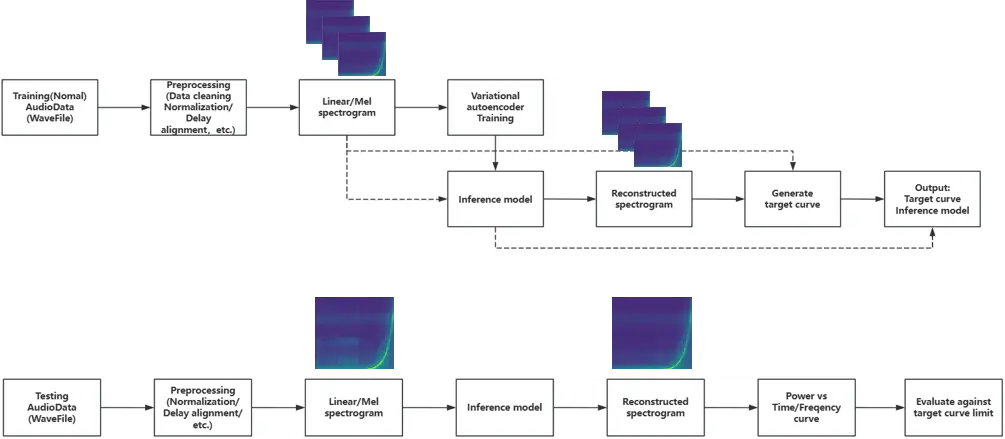
Lors de l'entraînement du modèle, nous construisons l'algorithme en suivant le flux de travail ci-dessous.
Comment utiliser et déployer l'algorithme d'IA
Préparation
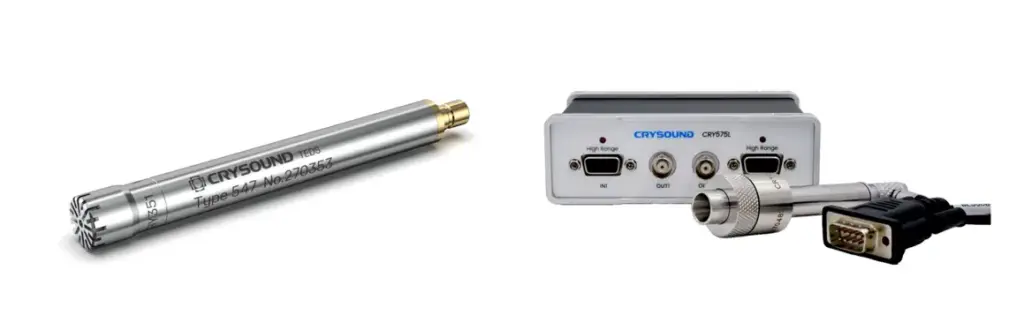
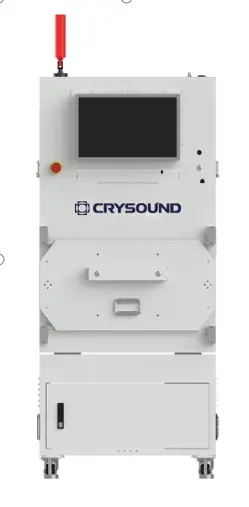
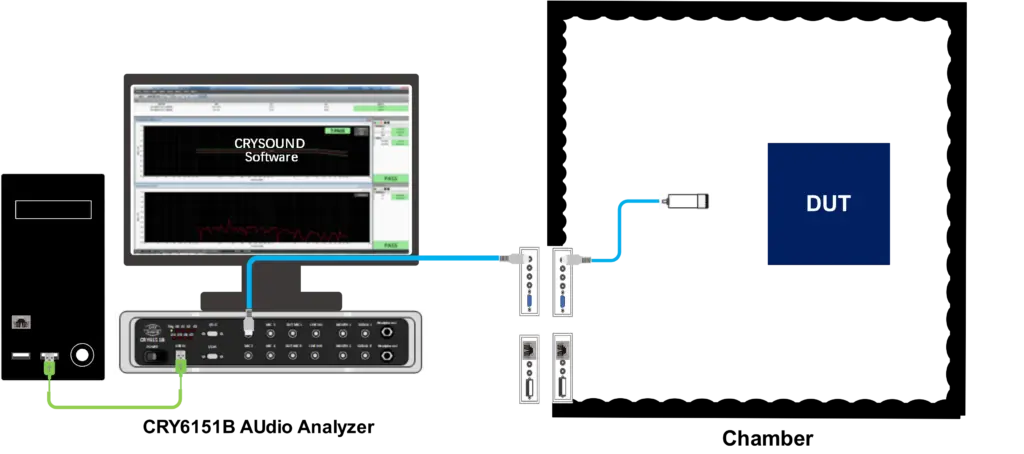
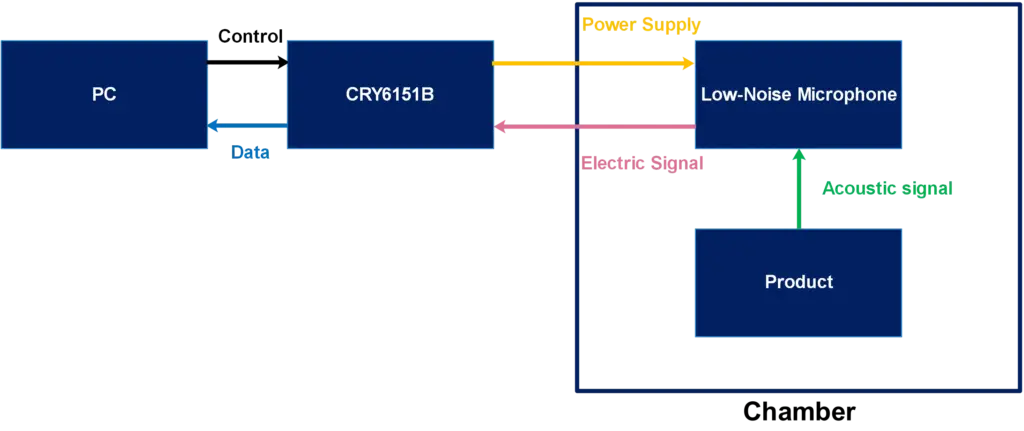
Commencez par préparer un microphone de mesure à faible bruit / un simulateur d'oreille à faible bruit et une alimentation pour microphone afin de pouvoir capturer des signatures anormales subtiles tout en fournissant une alimentation stable au micro.
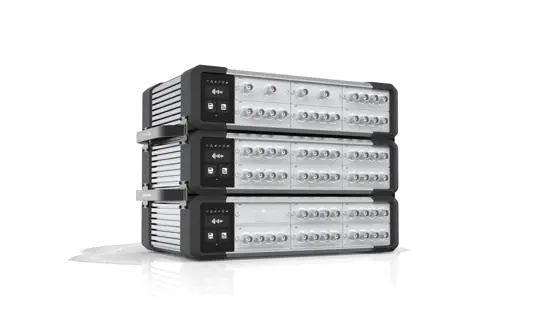
Ensuite, vous aurez besoin d'une carte son pour enregistrer le signal et téléverser les données vers l'ordinateur hôte.
Troisièmement, utilisez un dispositif de fixation ou gabarit de positionnement pour maintenir le produit de manière à ce que le positionnement soit reproductible et que chaque enregistrement soit effectué dans des conditions cohérentes.
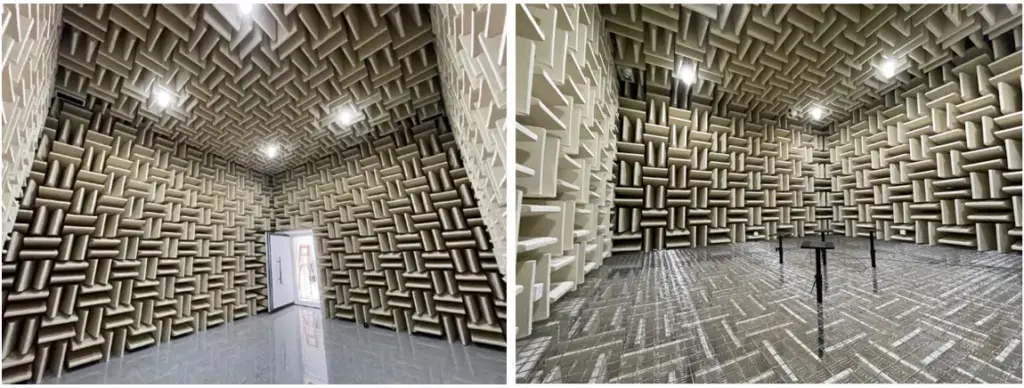
Enfin, assurez-vous de disposer d'un environnement acoustique calme et stable : en laboratoire, une chambre anéchoïque est idéale ; sur une ligne de production, on utilise généralement un caisson d'insonorisation pour contrôler le bruit ambiant et maintenir la cohérence des mesures.
Développement du modèle
Tout d'abord, créez une séquence de test dans SonoLab, sélectionnez « Deep Learning » et appliquez ce paramètre.
Ensuite, sélectionnez le module d'algorithme d'IA de son anormal approprié et son API correspondante
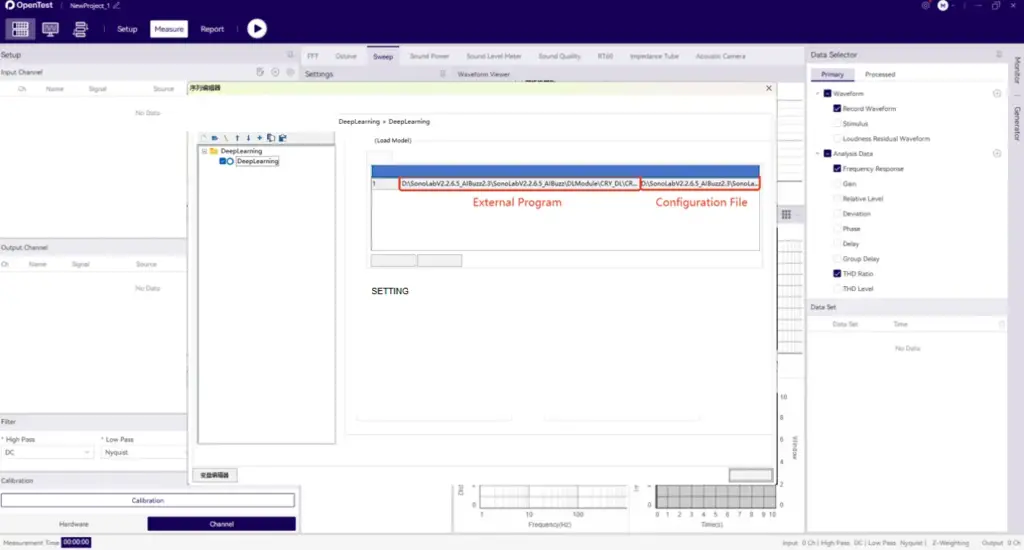
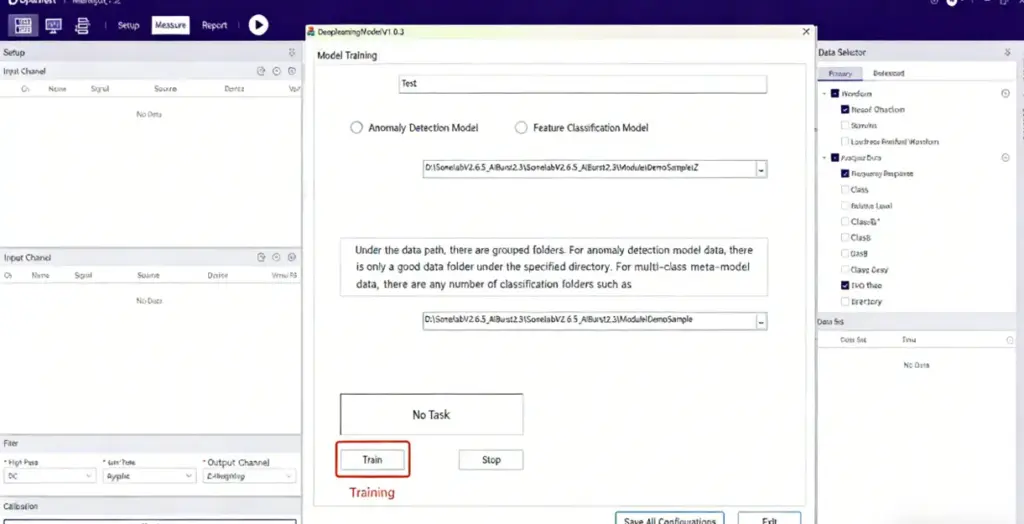
Ouvrez ensuite les Paramètres et indiquez le type de modèle, ainsi que les chemins des fichiers pour le jeu de données d'entraînement et le jeu de données de test.
Cliquez sur Train et attendez que le modèle ait terminé son entraînement (la durée de l'entraînement dépend du matériel de votre PC)
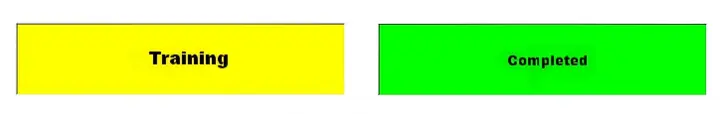
Pendant l'entraînement, l'indicateur d'état devient jaune. Une fois l'entraînement terminé, il passe au vert et affiche le message "Training completed".
Enfin, placez vos fichiers WAV de test dans le dossier de test spécifié et exécutez la séquence. Le modèle démarrera automatiquement et produira les résultats d'analyse.
Cas de test
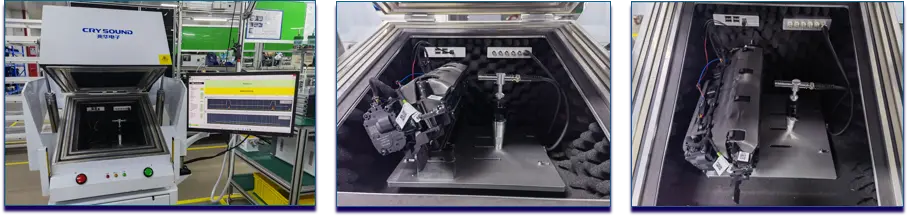
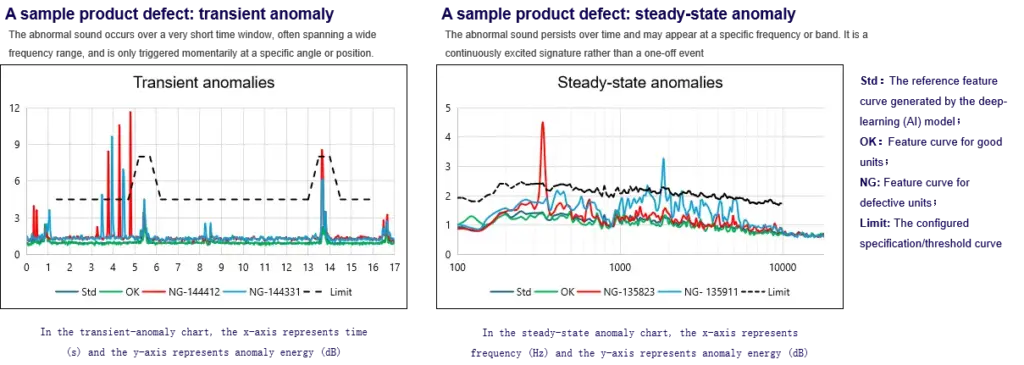
Schéma fonctionnel du système
Équipements
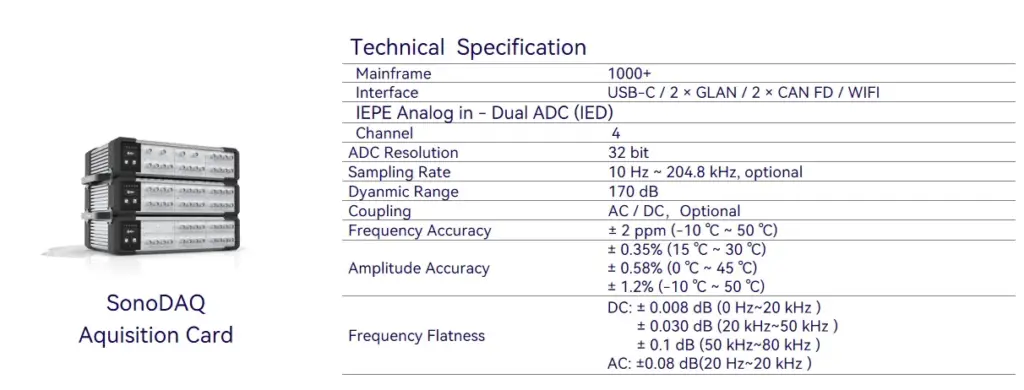
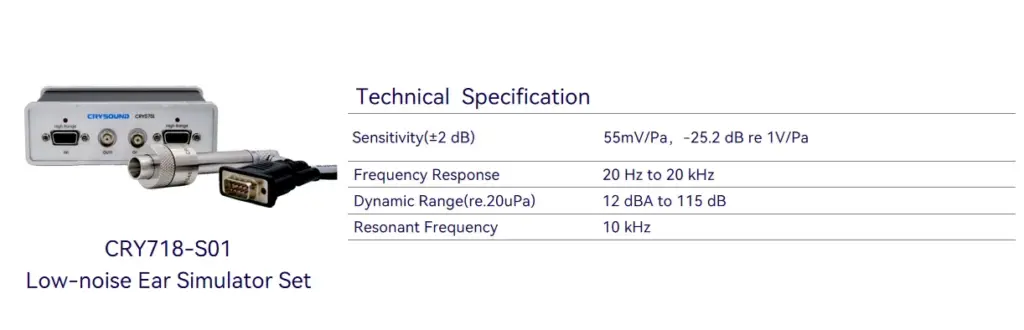
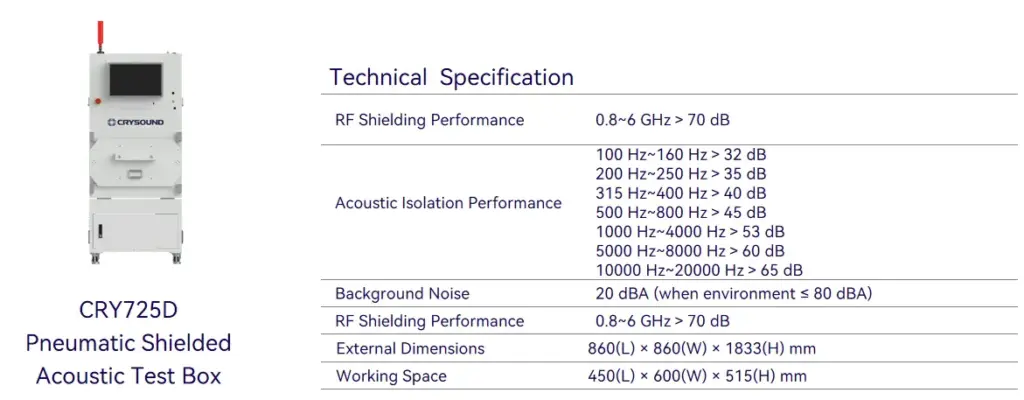
Davantage de détails techniques sont disponibles sur demande - veuillez utiliser le formulaire "Get in touch" ci-dessous. Notre équipe peut partager des réglages recommandés et un flux de travail sur site adapté à vos conditions de production.
Get Expert Advice for Your Application
Tell us about your testing requirements and our engineers will recommend the right solution.


