


이전 블로그 글인 Anomalous Sound Detection: From Human Ears to AI에서 우리는 수동 청취의 핵심 문제점을 다루고, CRYSOUND의 AI 기반 이상 음향 테스트 솔루션을 소개했으며, 학습 방식의 개요와 함께 이 시스템을 TWS 생산 라인에 어떻게 배포할 수 있는지 설명했습니다. 이번 글에서는 다음 단계로 나아가 CRYSOUND AI 이상 음향 알고리즘의 분석 원리를 더 깊이 살펴보고, 실제 테스트 셋업과 현장에서의 성능 사례를 공유한 뒤, 자체 도입이나 검증 시 활용할 수 있는 전체 구성 체크리스트로 마무리하겠습니다.
기존 알고리즘으로 이상을 검출할 때의 과제
실제 공장 환경에서 진짜 불량은 드물고 동시에 유형이 매우 다양하기 때문에, 감독 학습에 사용할 충분히 포괄적인 이상 음향 패턴 라이브러리를 구축하기가 어렵습니다.
잘 튜닝되었거나 경우에 따라 고도로 커스터마이즈된 룰 기반 알고리즘이라 해도 모든 비정상 패턴을 완전히 커버하는 경우는 거의 없습니다. 새로운 불량 모드, 미세한 변형, 생산 조건의 변화 등은 미리 정의된 임계값이나 특징 템플릿 밖으로 벗어나기 쉽고, 그 결과 미검출(escape)이 발생할 수 있습니다.
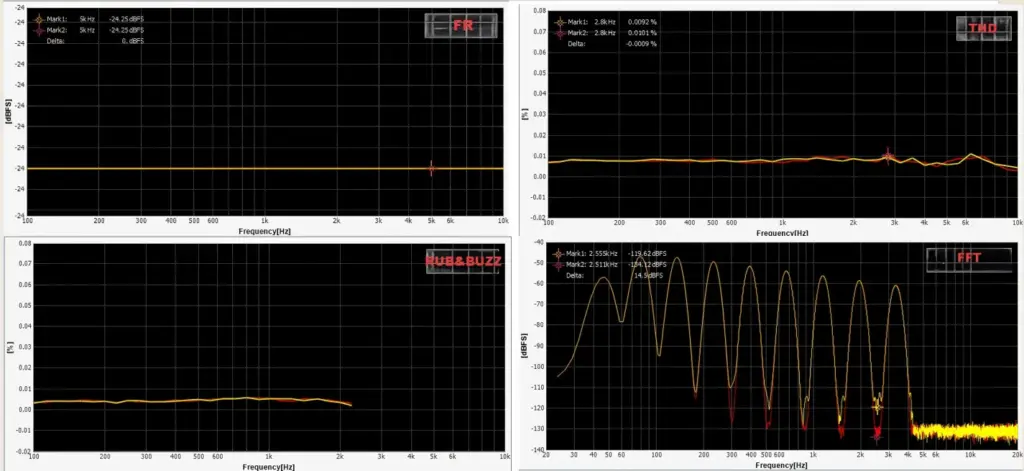
아래 그림에서는 수동으로 생성한 두 개의 WAV 파일을 비교합니다.
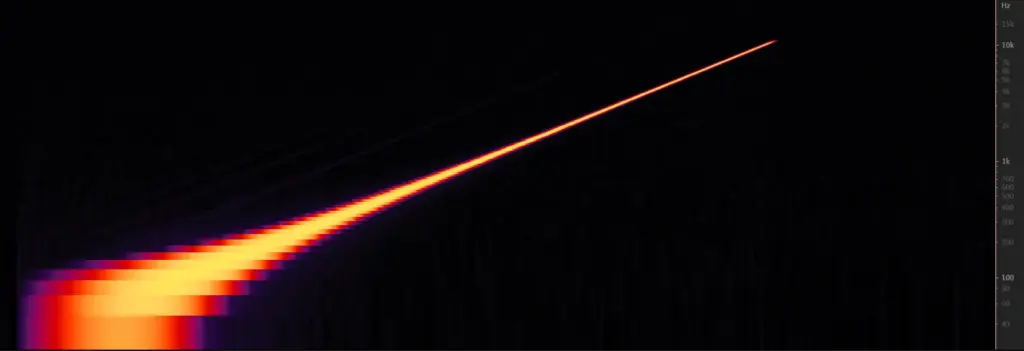
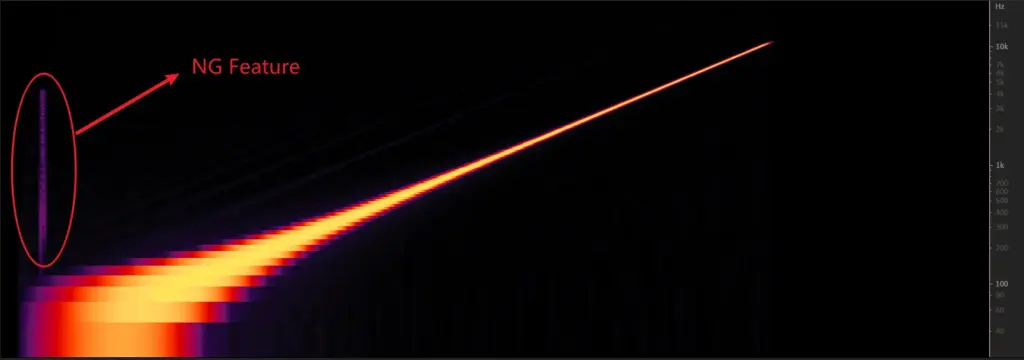
보시다시피 주파수 응답, THD, 일반적인 rub & buzz(R&B) 알고리즘과 같은 기존 검사로는 주입된 저레벨 노이즈 불량을 거의 검출하지 못하며, 전체 커브 차이는 약 0.1 dB에 불과합니다. 단순 FFT 비교에서는 두 WAV 파일 사이에 어느 정도 차이가 보이지만, 실제 생산 환경에서는 불량 에너지가 이보다 더 낮을 수 있어, 고정 임계값 아래로 떨어져 그대로 통과해 버릴 가능성이 매우 큽니다. 반면 시간-주파수 표현에서는, 단일 평균 커브의 작은 변화가 아니라 시간에 따라 구조화된 패턴으로 나타나기 때문에 비정상 신호를 훨씬 명확하게 확인할 수 있습니다.
AI 이상 음향 알고리즘의 원리
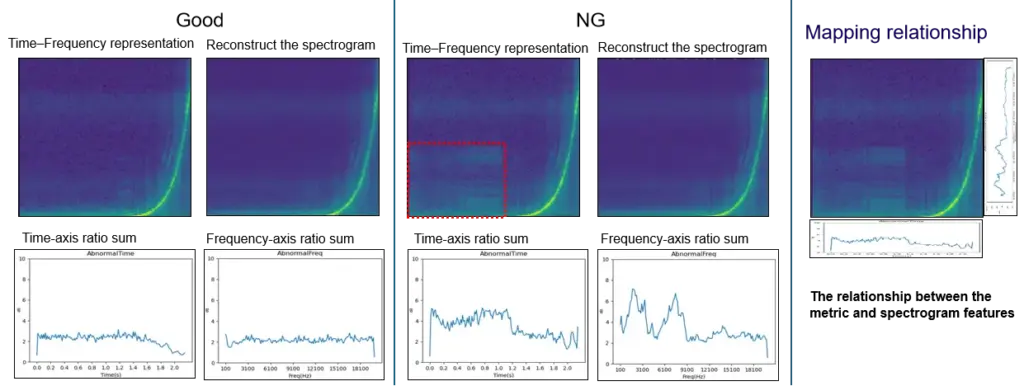
CRYSOUND는 딥러닝 프레임워크를 기반으로 한 이상 음향 검출 방식을 제안하며, 스펙트로그램을 재구성하고 잘 재구성되지 않는 부분을 측정함으로써 불량을 식별합니다. 이는 전통적인 룰 기반 방식의 핵심 한계를 돌파하여, 원리 차원에서 특히 미세하고 다양하며 이전에 없던 비정상 패턴까지 더 넓고 체계적으로 커버할 수 있게 해 줍니다.
아래 그림은 당사의 학습 및 추론 파이프라인에 적용되는 핵심 워크플로를 보여줍니다.
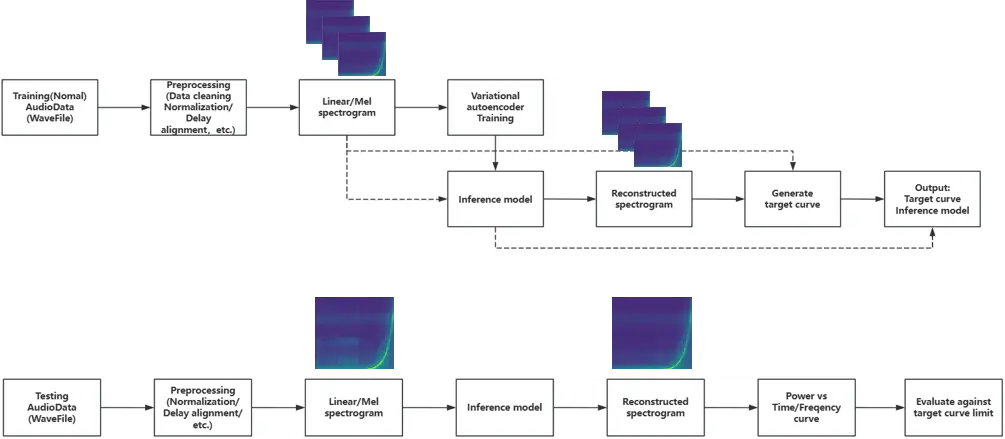
모델 학습 과정에서는 아래와 같은 워크플로를 따라 알고리즘을 구축합니다.
AI 알고리즘 사용 및 배포 방법
사전 준비
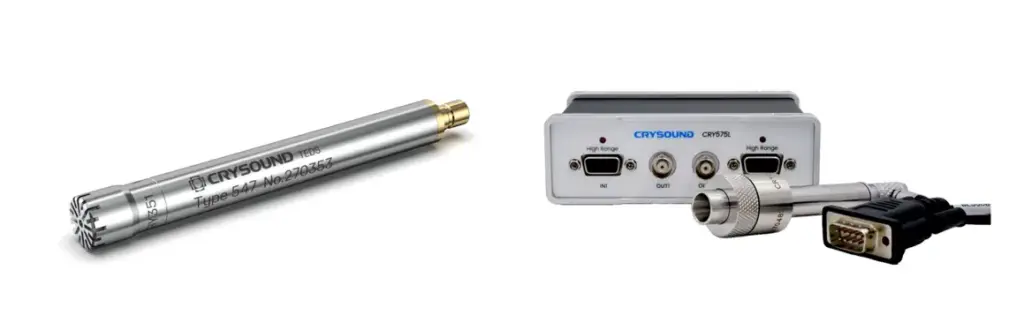
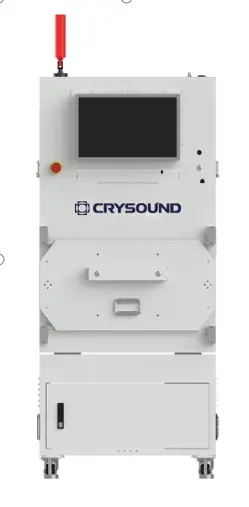
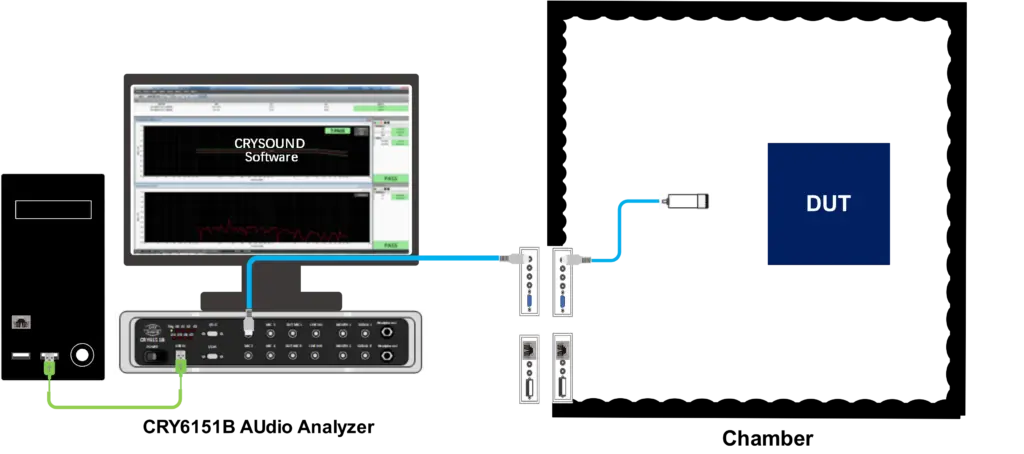
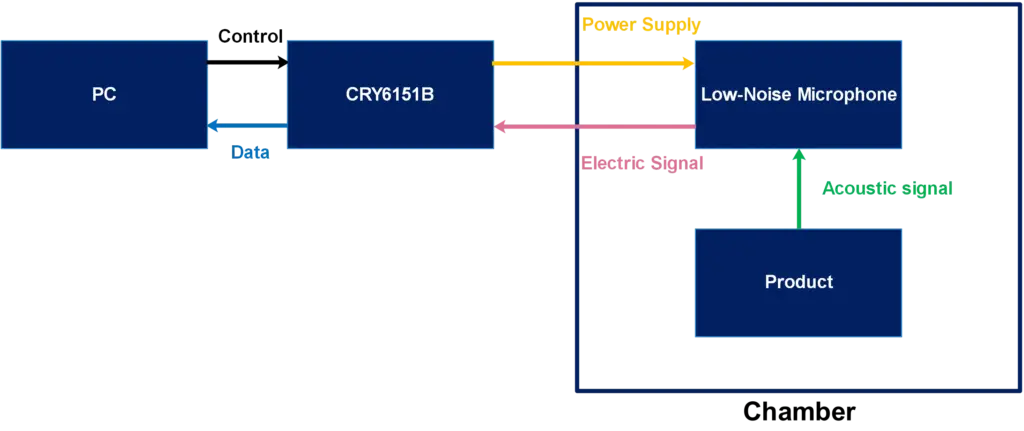
먼저 저소음 측정 마이크 또는 저소음 귀 시뮬레이터와 마이크 전원 공급 장치를 준비하여, 미세한 이상 신호를 포착하고 마이크에 안정적인 전원을 공급할 수 있도록 합니다.
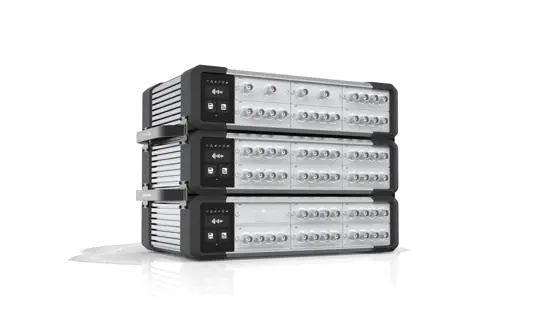
다음으로, 신호를 녹음하고 데이터를 호스트 PC로 업로드하기 위한 사운드 카드를 준비합니다.
세 번째로, 제품을 고정해 반복 가능한 위치에 둘 수 있도록 지그 또는 포지셔닝 지그를 사용하여, 모든 녹음이 항상 동일한 조건에서 이루어지도록 합니다.
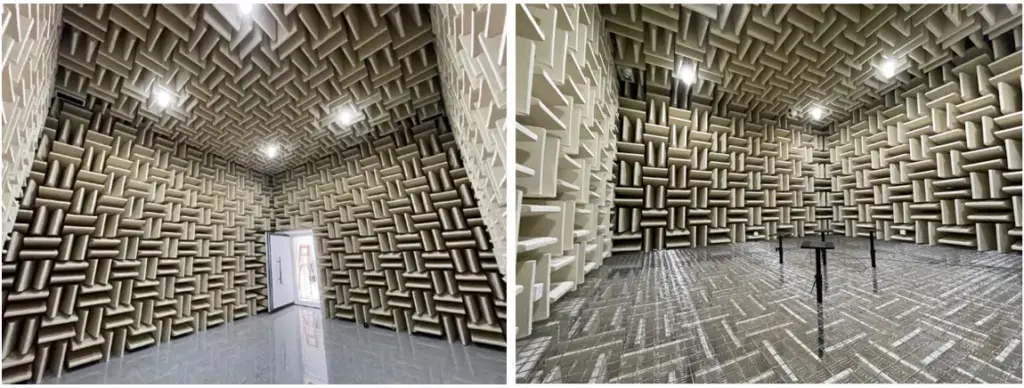
마지막으로, 조용하고 안정적인 음향 환경을 확보해야 합니다. 실험실에서는 무향실이 이상적이며, 생산 라인에서는 주변 소음을 제어하고 측정 일관성을 유지하기 위해 일반적으로 방음 박스를 사용합니다.
모델 개발
먼저 SonoLab에서 테스트 시퀀스를 생성한 뒤, "Deep Learning"을 선택하고 해당 설정을 적용합니다.
다음으로, 적합한 AI 이상 음향 알고리즘 모듈과 해당 API를 선택합니다
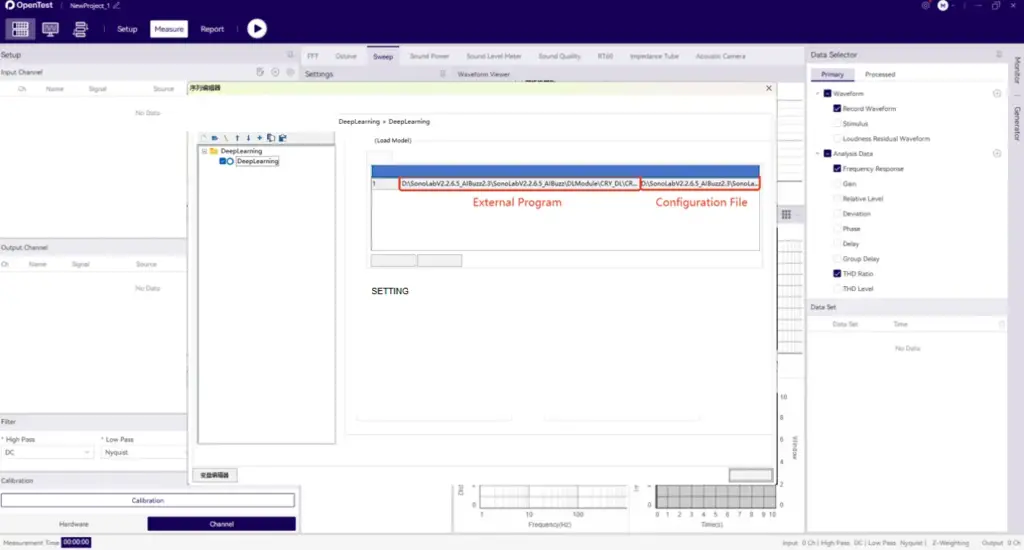
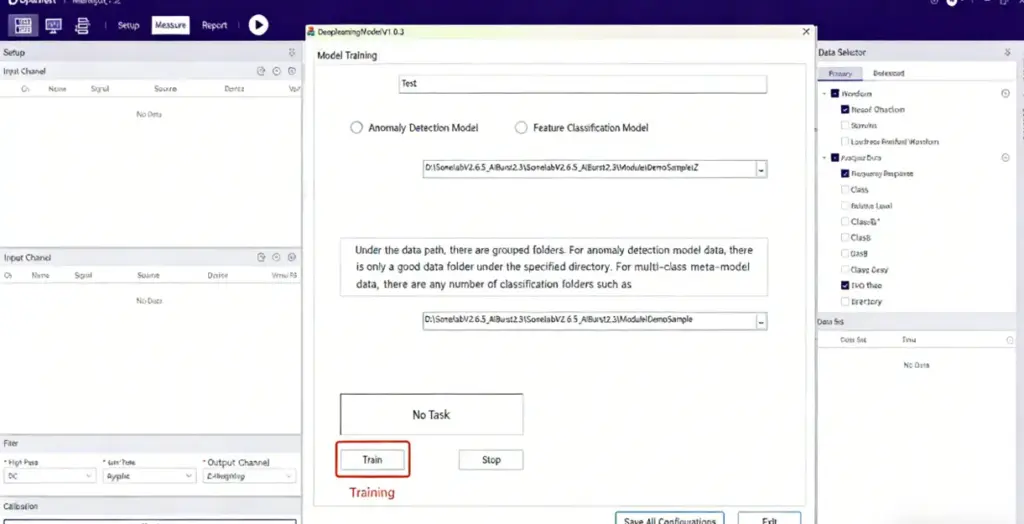
그다음 Settings를 열어 모델 유형과 학습 데이터셋, 테스트 데이터셋의 파일 경로를 지정합니다.
Train을 클릭하고 모델 학습이 완료될 때까지 기다립니다(학습 시간은 PC 하드웨어 성능에 따라 달라집니다)
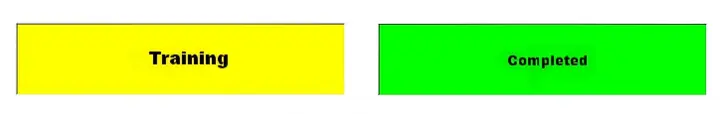
학습 중에는 상태 표시등이 노란색으로 변합니다. 학습이 완료되면 녹색으로 바뀌며 "Training completed" 메시지가 표시됩니다.
마지막으로, 테스트 WAV 파일을 지정된 테스트 폴더에 넣고 시퀀스를 실행합니다. 모델이 자동으로 시작되어 분석 결과를 출력합니다.
테스트 케이스
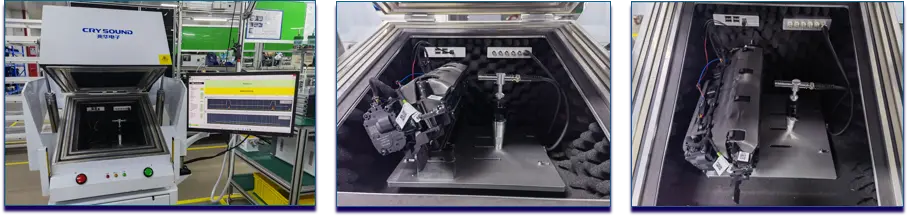
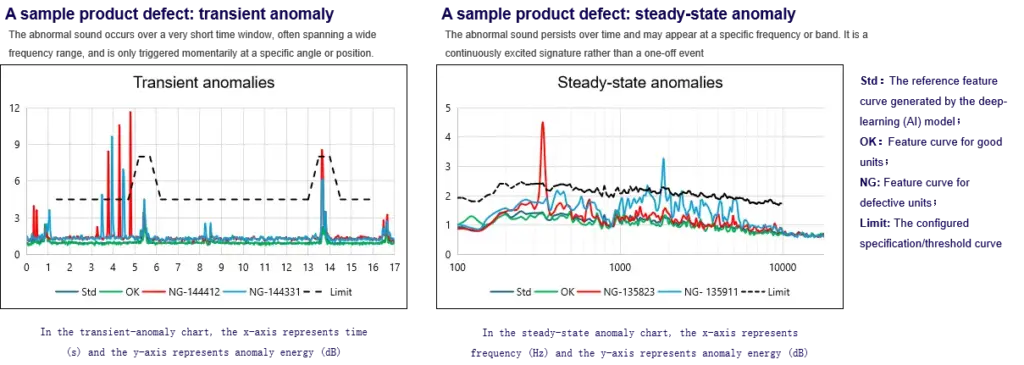
시스템 블록 다이어그램
설비
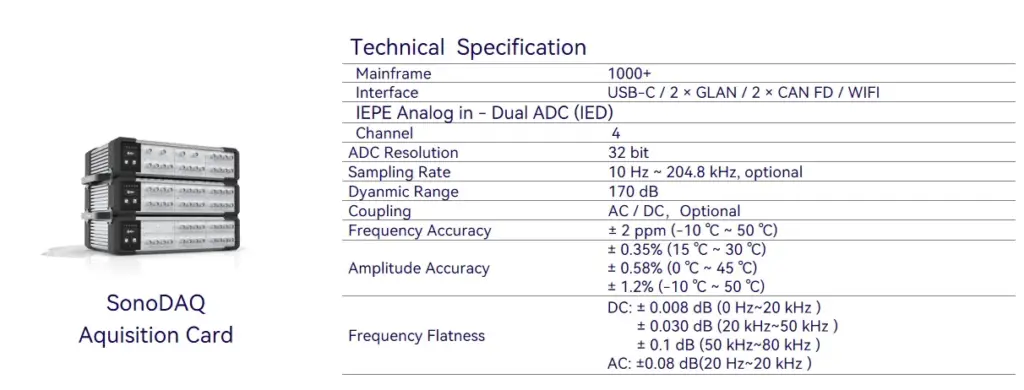
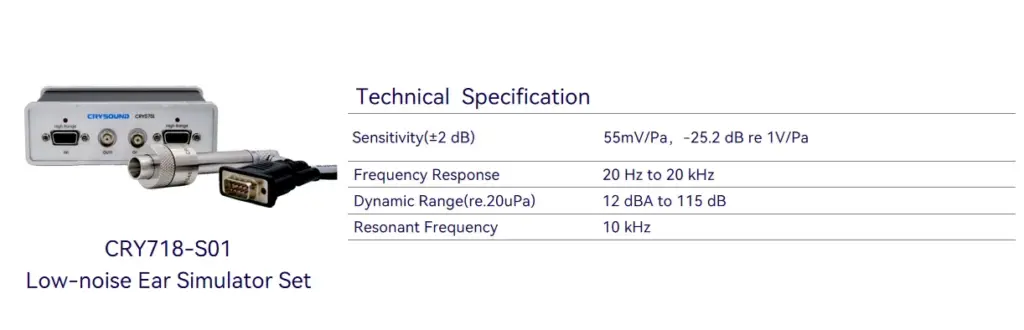
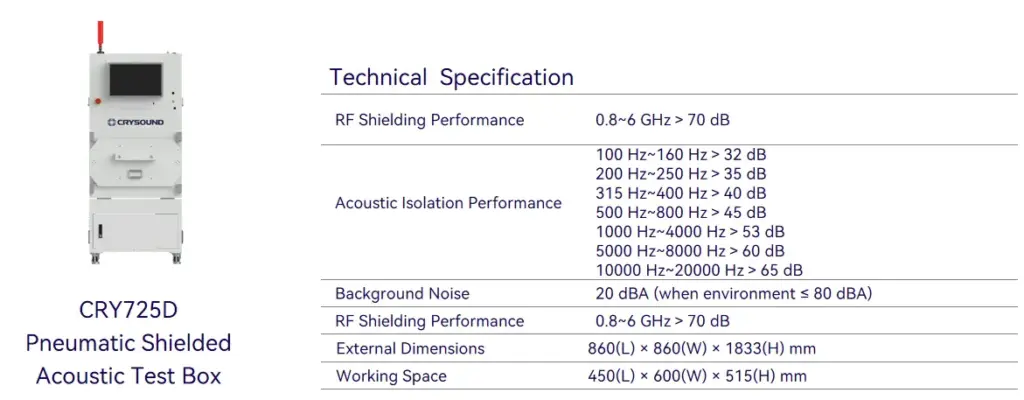
추가 기술 자료가 필요하시면 아래의 "Get in touch" 양식을 통해 요청해 주시기 바랍니다. 당사 팀이 귀사의 생산 환경에 맞춘 권장 설정과 현장 작업 흐름을 공유해 드릴 수 있습니다.
Get Expert Advice for Your Application
Tell us about your testing requirements and our engineers will recommend the right solution.


